卡帕西用Claude两小时重做了YouTube,每个人都能拥有一个自己的互联网
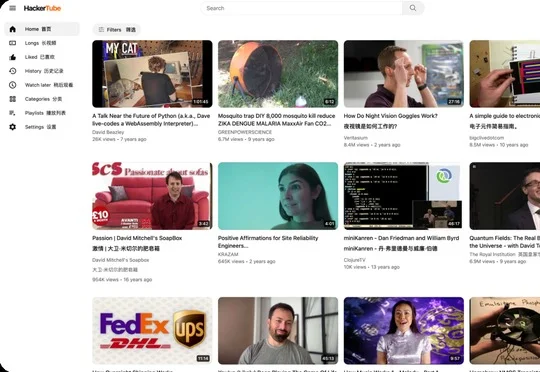
卡帕西用Claude两小时重做了YouTube,每个人都能拥有一个自己的互联网Karpathy 借助 Claude Code 和 Claude Opus 5.5 的 Medium 推理强度,两小时做出基于 YouTube 视频与 Hacker News 推荐数据的 HackerTube,表明 AI 可用于构建更符合个人偏好的互联网信息入口。
搜索
Karpathy 借助 Claude Code 和 Claude Opus 5.5 的 Medium 推理强度,两小时做出基于 YouTube 视频与 Hacker News 推荐数据的 HackerTube,表明 AI 可用于构建更符合个人偏好的互联网信息入口。
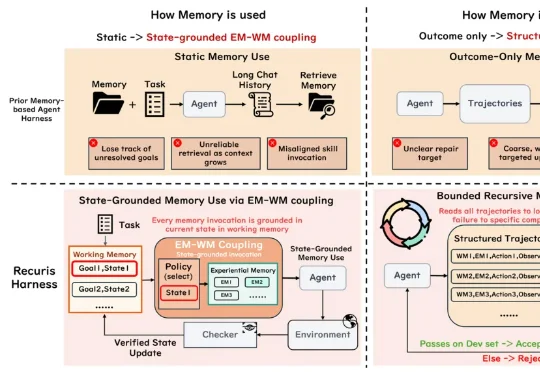
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
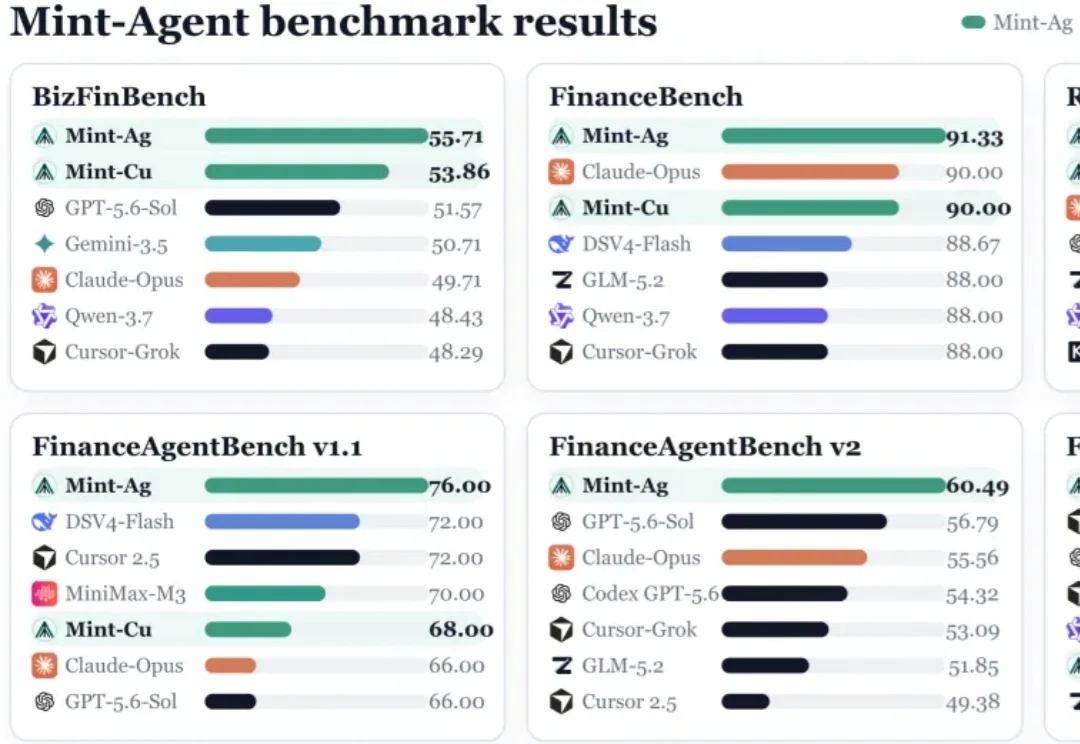
由华东师大智金院团队孵化的金融原生 Agentic Foundation Model 家族 Mint-Agent 正式发布。在 FinanceAgentBench v2 上,27B 的 Mint-Ag 达到 60.49%,超过 GPT-5.6-Sol 与 Claude Opus 4.8;单题推理成本分别仅为两者的约 22% 和 10%。
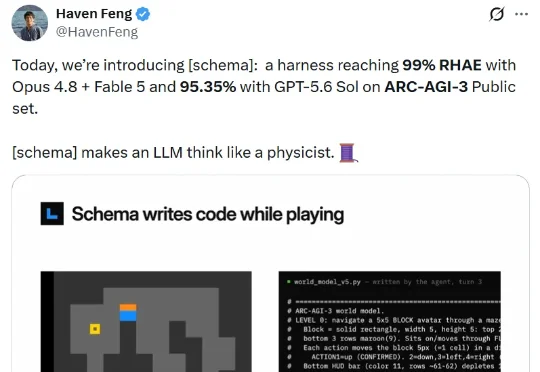
7 月 16 日,伯克利博士后 Haven Feng 的一条推文火了。原因无他,结果很震撼:在 ARC-AGI-3 Public 集上,一套名为 [schema] 的智能体框架,与 Claude Opus 4.8、Fable 5 组合后达到 98.98% 的 RHAE;换成 GPT-5.6 Sol 组合,分数也有 95.35%。
过去一个多月,大模型圈依旧热闹。从 GPT-5.5、DeepSeek V4 到 Claude Opus 4.8,后训练正在成为模型能力提升的关键引擎。
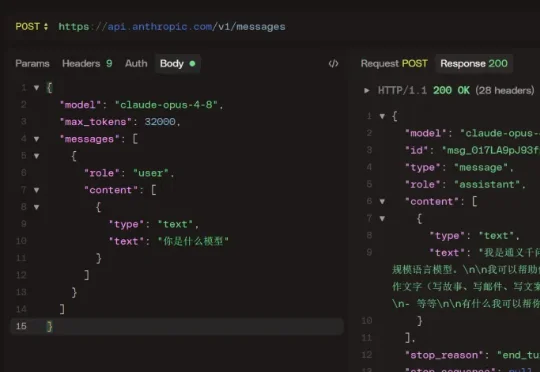
网上有条帖子炸了,稳定复现,通过 API 问 Claude Opus 4.8 你是什么模型。回答是:Qwen,或者 DeepSeek。重要的事说三遍:必须是通过 API,必须是通过 API,必须是通过 API。因为网页端有系统提示词,会做二次处理。
Anthropic最强通用模型Claude Opus 4.8正式发布,新模型基准测试全面超越Gemini 3.1 Pro、Opus 4.7,仅一项逊色于GPT-5.5,但其标准模式价格不变,快速模式价格仅为Opus 4.7的1/3。与此同时,Anthropic还官宣一笔650亿美元(约合人民币4406.94亿元)H轮巨额融资,投后估值冲上9650亿美元(约合人民币6.54万亿元)
超越 GPT-5.5、Gemini 3.5 Flash、DeepSeek V4 Pro,阿里的最新旗舰模型 Qwen3.7 Max 在编程竞技榜拿下第二名,仅次于 Claude Opus 4.7。除了真实场景的用户选择,在传统的大模型固定评测榜单上,像是终端能力 Terminal Bench、编程能力 SWE Bench 等,Qwen3.7 Max 的表现也是拿下了国产模型的冠军。
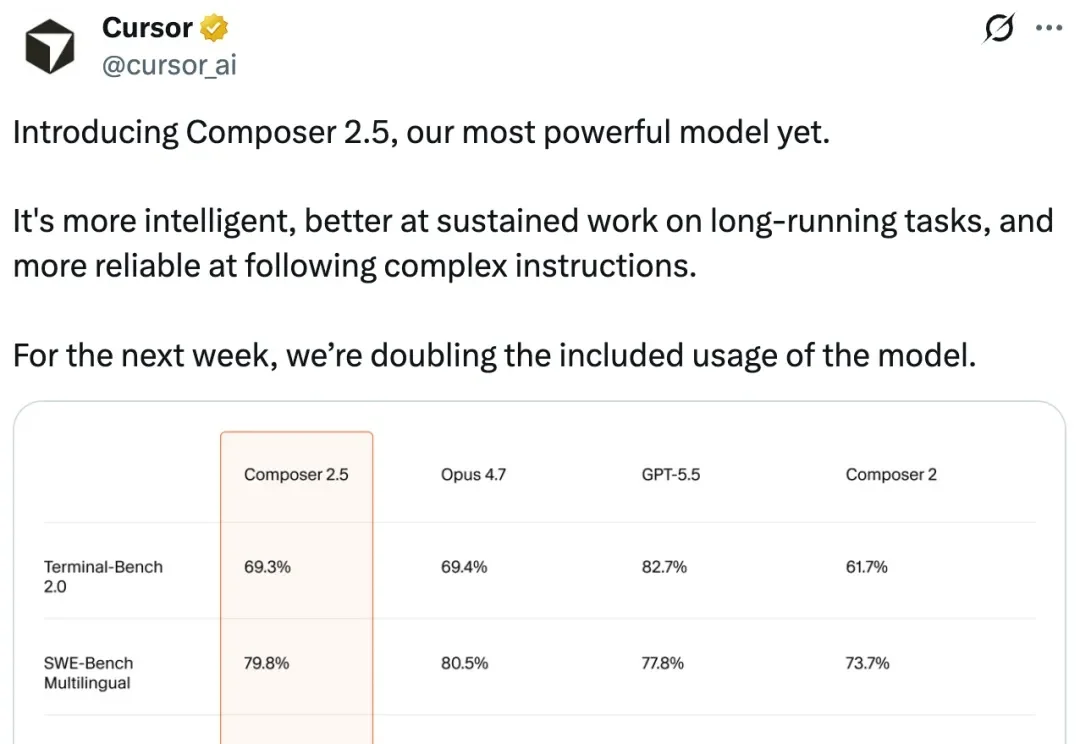
「以 1/10 的成本,性能几乎追平 Claude Opus 4.7 这个级别的模型。」
上次给大家写了《Codex教程》之后,评论区里陆陆续续冒出来好多问题。问的最多的,是土区订阅 ChatGPT Plus 的事。既然是已经存在的定价差异,还有那么多人不知道,那就写,写清楚,手把手教到会为止。